PGDay São Paulo
17 out - 2026 • 08:30 > 17 out - 2026 • 18:00
PGDay São Paulo
17 out - 2026 • 08:30 > 17 out - 2026 • 18:00
Descrição do evento
O PGDay é um evento presencial organizado pela comunidade PostgreSQL, com o objetivo de expandir o conhecimento sobre a tecnologia por meio de palestras, compartilhamento de experiências reais e conexão entre profissionais da área. A participação é gratuita.
As inscrições para esse evento encerram em 15 de outubro. Embora o evento não tenha custo, as vagas são limitadas à capacidade do espaço, por isso é importante garantir sua inscrição com antecedência.
Esperamos você para mais uma edição do PGDay, fortalecendo a comunidade PostgreSQL e compartilhando conhecimento de qualidade.
GRADE:
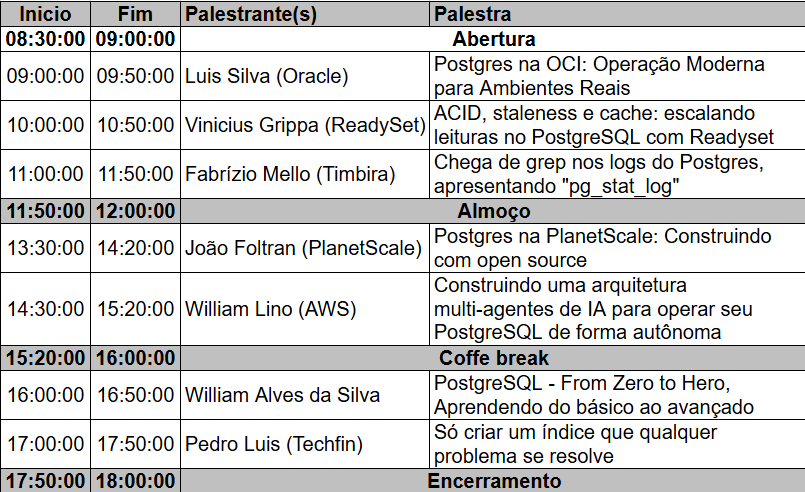
DESCRIÇÃO DAS PALESTRAS:
Postgres na OCI: Operação Moderna para Ambientes Reais - Luis Silva (Oracle)
Nesta palestra, vamos mostrar como executar PostgreSQL na Oracle Cloud Infrastructure com foco em ambientes reais de produção.
Serão abordados o funcionamento do Postgres na OCI, arquitetura, alta disponibilidade, principais features, extensões, backup, monitoramento e boas práticas de operação. A ideia é mostrar, na prática, como usar a OCI para rodar PostgreSQL com mais segurança, estabilidade e confiança.
http://www.linkedin.com/in/luislannes
ACID, staleness e cache: escalando leituras no PostgreSQL com Readyset - Vinicius Grippa (ReadySet)
Quando uma aplicação cresce, as leituras costumam ser o primeiro gargalo. Réplicas de leitura dividem a carga, mas cada query repetida continua sendo executada do zero. Um cache em Redis na frente do banco resolve a latência, só que passa para a aplicação a tarefa de decidir quando cada chave deixou de valer.
Nesta palestra mostramos como o Readyset escala leituras no PostgreSQL sem mudar o código da aplicação. Ele fica entre a aplicação e o banco como um proxy compatível com o protocolo do Postgres e oferece dois tipos de cache. O shallow funciona por TTL. É simples, previsível e serve para leituras que não dependem de atualização em tempo real. O deep vem de uma pesquisa do MIT (o projeto Noria). Ele atualiza os resultados de forma incremental a partir do fluxo de replicação do banco, sem TTL e sem invalidação escrita à mão.
Também discutimos o que "consistente" quer dizer para quem lê os dados. ACID descreve garantias dentro de uma transação, e o nível de isolamento define qual versão dos dados ela enxerga. Uma transação em REPEATABLE READ lê o snapshot do momento em que começou, e uma réplica lê só o que já chegou até ela. Comparando esses casos com o deep cache, mostramos em que situações uma leitura no Readyset traz um estado mais recente do que a mesma leitura feita no banco, e em quais ele não oferece as mesmas garantias.
Chega de grep nos logs do Postgres, apresentando "pg_stat_log" - Fabrízio Mello (Timbira)
Quando algo dá errado no Postgres, a resposta está no log, e para saber quais erros mais ocorrem você precisa de ferramentas externas (grep, coletores, etc) e acesso de alguma forma aos logs.
E se essa informação já estivesse agregada dentro do próprio banco, em uma view? O pg_stat_log conta as mensagens de log por severidade, SQLSTATE, banco, usuário e tipo de backend, e expõe tudo em SQL, como qualquer outra estatística cumulativa. Sem depender de nada fora do PostgreSQL.
Nesta palestra mostro uso prático em produção e os limites da extensão.
https://github.com/fabriziomello/pg_stat_log
https://www.linkedin.com/in/fabriziomello/
https://timbira.com.br
Postgres na PlanetScale: Construindo com open source - João Foltran (PlanetScale)
Um mergulho nas escolhas de arquitetura e nos aprendizados operacionais que moldaram o DBaaS Postgres da PlanetScale. Da decisão de design à operação em escala para milhares de clientes, tudo foi construído sobre uma base de software de código aberto.
Vamos percorrer os principais desafios dessa jornada: alta disponibilidade, HA, pooling de conexões e observabilidade e os pensamentos por trás de cada decisão. Mais do que mostrar o que funcionou, vamos compartilhar o que aprendemos pelo caminho e como o ecossistema open source foi peça central na construção de um produto confiável em escala.
https://www.linkedin.com/in/joaofoltran/
https://planetscale.com
Construindo uma arquitetura multi-agentes de IA para operar seu PostgreSQL de forma autônoma - William Lino (AWS)
Imagine o seguinte: são 2 da manhã de uma terça-feira. Seu cluster de banco de dados, o coração pulsante da sua plataforma de e-commerce, está engasgando de repente. A CPU está em 100%, as queries estão dando timeout, e você é o plantonista que precisa resolver o problema.
E o pior: você tem exatamente 30 minutos para identificar os culpados, ajustar o banco de dados e estabilizar tudo antes que a liderança acorde exigindo respostas.
Parece familiar? Todos nós já passamos por isso — vasculhando métricas do nossos Dashboards de Observabilidade manualmente, ajustando parâmetros em pânico e cruzando os dedos para que um VACUUM ANALYZE não piore as coisas. Mas e se você não precisasse mais fazer isso? E se você tivesse um Agente de Banco de Dados autônomo, um parceiro de raciocínio, capaz de diagnosticar os gargalos, formular hipóteses de correção e até implementa-las de forma autônoma, tudo isso explicando sua lógica como um DBA sênior movido a cafeína?
Nesta sessão veremos na prática como implementar uma arquitetura multi-agente utilizando Strands para efetuar health checks e aplicar fixes em nossos clusters PostgreSQL.
https://www.linkedin.com/in/williamlinooliveira/
https://aws.com
PostgreSQL - From Zero to Hero, Aprendendo do básico ao avançado - William Alves da Silva
Sabe aquele banco de dados que todo mundo diz que "é bom", mas que a gente acaba usando só pra SELECT * FROM tabela? Pois é, o PostgreSQL merece mais do que isso.
Nesta palestra, a gente vai começar do absoluto zero, sem medo do psql e sem pressa, e ir subindo o nível aos poucos, até chegar nos recursos que fazem o Postgres parecer um canivete suíço com superpoderes. No caminho, vamos desmistificar aquele monte de coisa que parece complicada (mas não é tanto assim), ver o que realmente faz diferença na hora de escrever queries melhores e descobrir por que tanta gente se apaixona por esse banco.
https://www.linkedin.com/in/william-alves-da-silva/
Só criar um índice que qualquer problema se resolve - Pedro Luis (Techfin)
Quando um banco de dados começa a apresentar lentidão, a primeira solução normalmente é: “vamos criar índices”. Porém, será que o problema realmente está na ausência de índices?
Vamos explorar os principais fatores que impactam a performance em PostgreSQL, mostrando que otimização vai muito além de simplesmente indexar tabelas. Em muitos cenários corporativos, problemas de desempenho estão diretamente ligados à queries mal escritas, uso inadequado de recursos da infraestrutura, ausência de testes de carga e falta de entendimento sobre o comportamento do banco em ambientes com alto volume de leitura e escrita.
https://www.linkedin.com/in/pedrolteixeiradata/
ORGANIZAÇÃO:
Timbira
PATROCÍNIO:
Oracle
ReadySet
Política do evento
Cancelamento de pedidos pagos
Cancelamentos de pedidos serão aceitos até 7 dias após a compra, desde que a solicitação seja enviada até 48 horas antes do início do evento.
Saiba mais sobre o cancelamentoEdição de participantes
Você poderá editar o participante de um ingresso apenas uma vez. Essa opção ficará disponível até 24 horas antes do início do evento.
Saiba como editar participantesLocal
Oracle Brasil
Rua Doutor José Áureo Bustamante, 455
São Paulo, SP
Sobre o produtor
Timbira
Métodos de pagamento
Compre com total segurança
Os dados sensíveis são criptografados e não serão salvos em nossos servidores.
Precisando de ajuda?
Acessa a nossa Central de Ajuda Sympla ou Fale com o produtor.